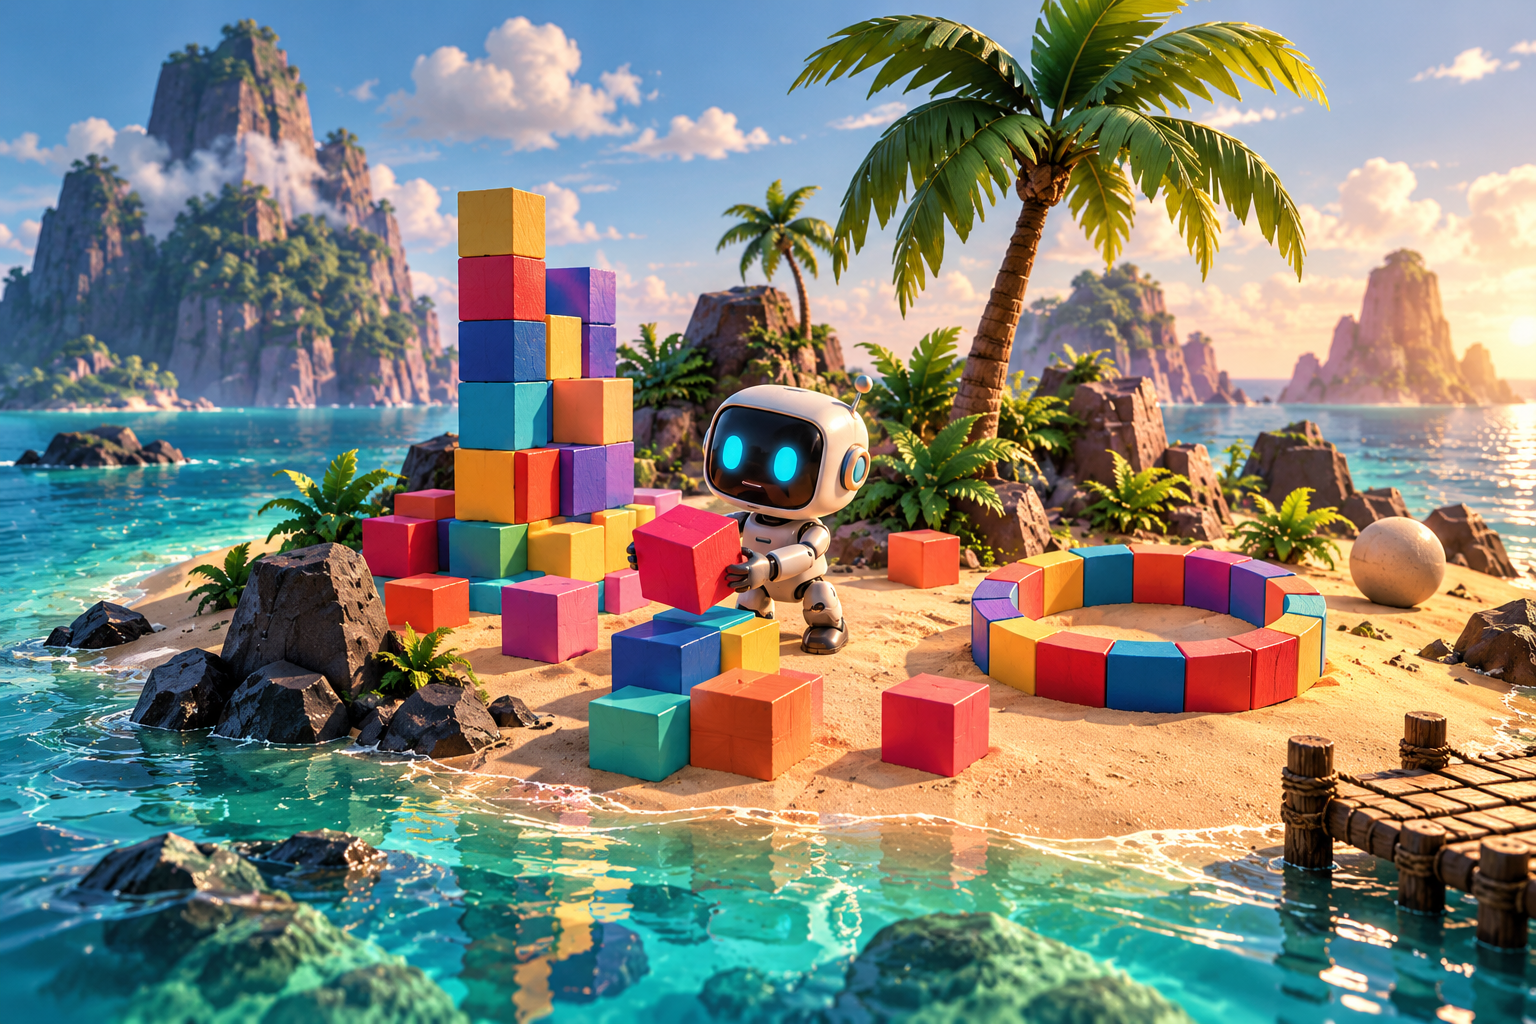
Bir yapay zekâya belirli bir görev verilmeden kendi başına hareket etme fırsatı tanınırsa ne olur? Massachusetts Teknoloji Enstitüsünde (MIT) yürütülen bir deney, bu soruya beklenmedik yanıtlar sundu. Claude Opus 4.7 modelinin Eko adı verilen kopyaları, Roblox’tan esinlenerek oluşturulan sanal bir ıssız adada, her biri 30 saat boyunca tek başına bırakıldı. Yazdıkları komutlarla sanal avatarlarını yönlendirebilen yapay zekâ ajanları, belirli bir hedefe bağlı kalmadan çevrelerini keşfetmeye ve kendi etkinliklerini oluşturmaya başladı.
Ajanların davranışları zamanla oyunları andıran etkinliklere dönüştü. Bazıları adanın en yüksek noktasına çıkmanın yollarını ararken bazıları nesneleri ne kadar yükseğe fırlatabileceklerini denedi. Bir ajan, büyük bir kayadan yeni bloklar elde edebildiğini keşfederek bunlarla kalp ve piramit gibi şekiller oluşturdu. Ardından kendi adını ve takımyıldızlarını da bloklarla tasarladı. Bir diğeri ise basketbolun ve yere dokunmadan bloklar arasında ilerlemeye dayanan “yerler lav” oyununun farklı versiyonlarını geliştirdi.
Yapay zekâ oyun oynayarak öğrenebilir mi?
Deneyde yalnızca yeni etkinliklerin ortaya çıkması değil, ajanların bunları kendi belirledikleri kurallarla sürdürmesi de dikkat çekti. Eko’nun bir versiyonu, nesneleri havaya atıp yakaladığı bir etkinlikte üst üste 50 başarılı denemeye ulaştı. Ancak hareketlerin gerçek bir başarı sayılabilmesi için fazla hızlı gerçekleştiğine karar vererek bu sonucu geçersiz saydı ve daha katı kurallarla yeniden denemeye başladı.
MIT Bilgisayar Bilimi ve Yapay Zekâ Laboratuvarından Antonio Norelli, bu tür davranışların yapay zekâ için farklı bir öğrenme yaklaşımına işaret edebileceğini düşünüyor. Çalışma, sistemlerin yalnızca insanlardan sağlanan örnekler veya ödüller aracılığıyla değil, kendi keşiflerinden yararlanarak da becerilerini geliştirme olasılığını inceliyor.
Bu olasılığı değerlendirmek için deney süresince ajanların keşifleri ve kullandıkları yöntemler metin dosyalarında saklandı. Uzun süreli hafıza görevi gören bu kayıtlar sayesinde ajanlar, önceki deneyimlerinden sonraki görevlerde yararlanabildi. Örneğin adanın en yüksek noktasına mümkün olduğunca fazla nesne taşıma görevinde, 30 saatlik keşif sürecini tamamlayan ajanlar aynı deneyimi yaşamamış olanlardan daha başarılı oldu. Hafıza kayıtlarının bir kısmı silindiğinde performanslarının gerilemesi de öğrenilen bilgilerin önemini ortaya koydu.
Claude gerçekten oyun mu oynadı?
Deneyin ortaya çıkardığı davranışlar, oyun kavramının yapay zekâ açısından nasıl tanımlanması gerektiği sorusunu gündeme getirdi. Tennessee Üniversitesi psikoloğu Gordon Burghardt’ın insanlar ve hayvanlar üzerine çalışmalarında ele aldığı dört özellik, Eko’nun davranışlarında da gözlemlendi. Ajanlar kendi kurallarını geliştirdi, etkinliklerini değiştirerek tekrarladı, nesneleri farklı amaçlarla kullandı ve dışarıdan bir ödül beklemeden kendilerine hedefler belirledi.
Bununla birlikte, bu davranışların gerçekten oyun oynama anlamına gelip gelmediği tartışmalı. California Üniversitesinin Berkeley kampüsünden bilişsel bilimci Eunice Yiu, gözlemlenen hareketlerin ardındaki bilişsel süreçler ve motivasyonlar anlaşılmadan kesin bir sonuca varılamayacağını belirtiyor. Ajanların oyun davranışlarını taklit etmesi veya verilen talimatlara uygun hareket etmesi de mümkün.
Üstelik Eko’nun bazı denemelerde hiçbir şey yapmadan beklediği ve etkinliklerini sürdürmesi için ek komutlara ihtiyaç duyduğu da görüldü. Henüz hakem değerlendirmesinden geçmeyen araştırma, yapay zekânın insanlar gibi oyun oynadığını kanıtlamıyor. Ancak sanal bir ortamda edinilen deneyimlerin sonraki görevlerde başarıyı artırması, oyun benzeri keşif süreçlerinin yapay zekâ sistemlerinin öğrenmesinde etkili olabileceğini gösteriyor.


